AI
AI가 쓴 글에는 어떤 흔적이 남을까요? OpenAI textGrain
발행일:
OpenAI가 문장 생성 과정에 통계적 흔적을 남기는 textGrain을 공개했습니다. EU 제품 적용과 전 세계 API 선택 도입의 차이, 편집 뒤의 탐지 한계, 글을 만드는 사람에게 남는 질문을 살펴봅니다.
AI로 초안을 만들고 문장을 고쳐 블로그에 올렸다고 생각해 보겠습니다. 글을 읽는 사람은 어디까지 사람이 썼고, 어디에 AI가 관여했는지 알 수 있을까요? 눈에 보이지 않는 흔적이 남는다면, 그 흔적으로 무엇까지 판단할 수 있을까요?
OpenAI가 10월 5일 공개한 textGrain은 이 질문을 실제 제품으로 가져옵니다. 문장을 생성하는 과정에 통계적 신호를 남기고, 나중에 그 신호를 찾는 텍스트 워터마킹 기술입니다. 글을 만들고 검토하는 사람에게는 적용 범위만큼이나 탐지 결과를 어떻게 읽어야 하는지가 중요해졌습니다.
먼저, 어디에 적용되는 걸까요?
발표 당일부터 전 세계 API 고객은 일부 지원 모델에서 워터마킹을 선택해 켤 수 있습니다. 기본값은 꺼짐입니다. ChatGPT와 Codex는 EU의 적용 대상 사용자·텍스트 출력에 앞으로 수주에 걸쳐 도입됩니다. EU에서는 모든 요금제가 범위에 포함되지만, 출시 시점부터 전 세계 기본 기능이 되는 것은 아닙니다.
텍스트 탐지기도 누구나 바로 사용할 수 있는 공개 도구로 나오지는 않았습니다. 초기 접근은 승인된 연구자와 전문 기관으로 제한되며, 신청을 받아 개별적으로 검토합니다. OpenAI 공식 발표
문장 안에 남는 것은 무엇일까요?
언어 모델은 다음에 올 토큰을 하나씩 고릅니다. 토큰은 단어 하나일 수도, 단어의 일부일 수도 있습니다. 같은 뜻을 표현할 선택지가 여러 개라면, 그 선택 과정에 일정한 통계적 신호를 실을 여지가 생깁니다.
기술 보고서에서 설명하는 textGrain은 비밀 키와 앞선 문맥을 이용해 토큰 선택을 조정합니다. 어휘를 묶음으로 나누어 계산하고, 각 묶음 안에서는 원래 토큰들의 상대적인 확률을 유지합니다. 이때 워터마크를 남기기 위해 줄어드는 생성의 무작위성에 한도를 두는 것이 설계의 핵심입니다. 같은 질문에도 다양한 답변이 나올 여지를 관리하면서 신호를 남기는 방식입니다.
탐지기는 같은 키와 설정을 이용해, 관찰된 토큰들이 우연이라고 보기 어려운 패턴을 보이는지 검사합니다. 비밀 키는 워터마크를 만들고 찾기 위한 기술 요소입니다. 글쓴이의 신원을 확인하는 장치로 이해하면 곤란합니다. textGrain 기술 보고서
복사한 글 안에 숨은 문자나 보이지 않는 공백을 끼워 넣는 방식도 아닙니다. 신호는 단어 선택의 패턴에 들어갑니다. OpenAI 도움말은 원문 표현을 유지해 재사용하면 신호도 남을 것으로 예상하지만, 짧거나 표현 선택의 여지가 적은 글에서는 그대로 옮겨도 탐지를 보장하지 않는다고 설명합니다. OpenAI 도움말
문장을 고치면 흔적도 달라집니다
워터마크가 없어도 있다고 판정하는 오탐, 있어도 찾지 못하는 미탐이 모두 가능합니다. 짧은 글이나 수학처럼 표현 선택이 제한되는 글에서는 탐지가 더 어렵습니다. 편집과 번역도 신호를 약하게 만들 수 있습니다.
OpenAI가 공개한 400토큰 분량의 영어 답변 실험에서는 단어를 동의어로 바꾸지 않았을 때 약 92%였던 탐지율이, 10%를 바꾸면 66%, 25%를 바꾸면 17%로 낮아졌습니다. 특정 평가 조건의 결과이며, 한국어 블로그 글이나 모든 편집 방식에 그대로 적용할 수치는 아닙니다.
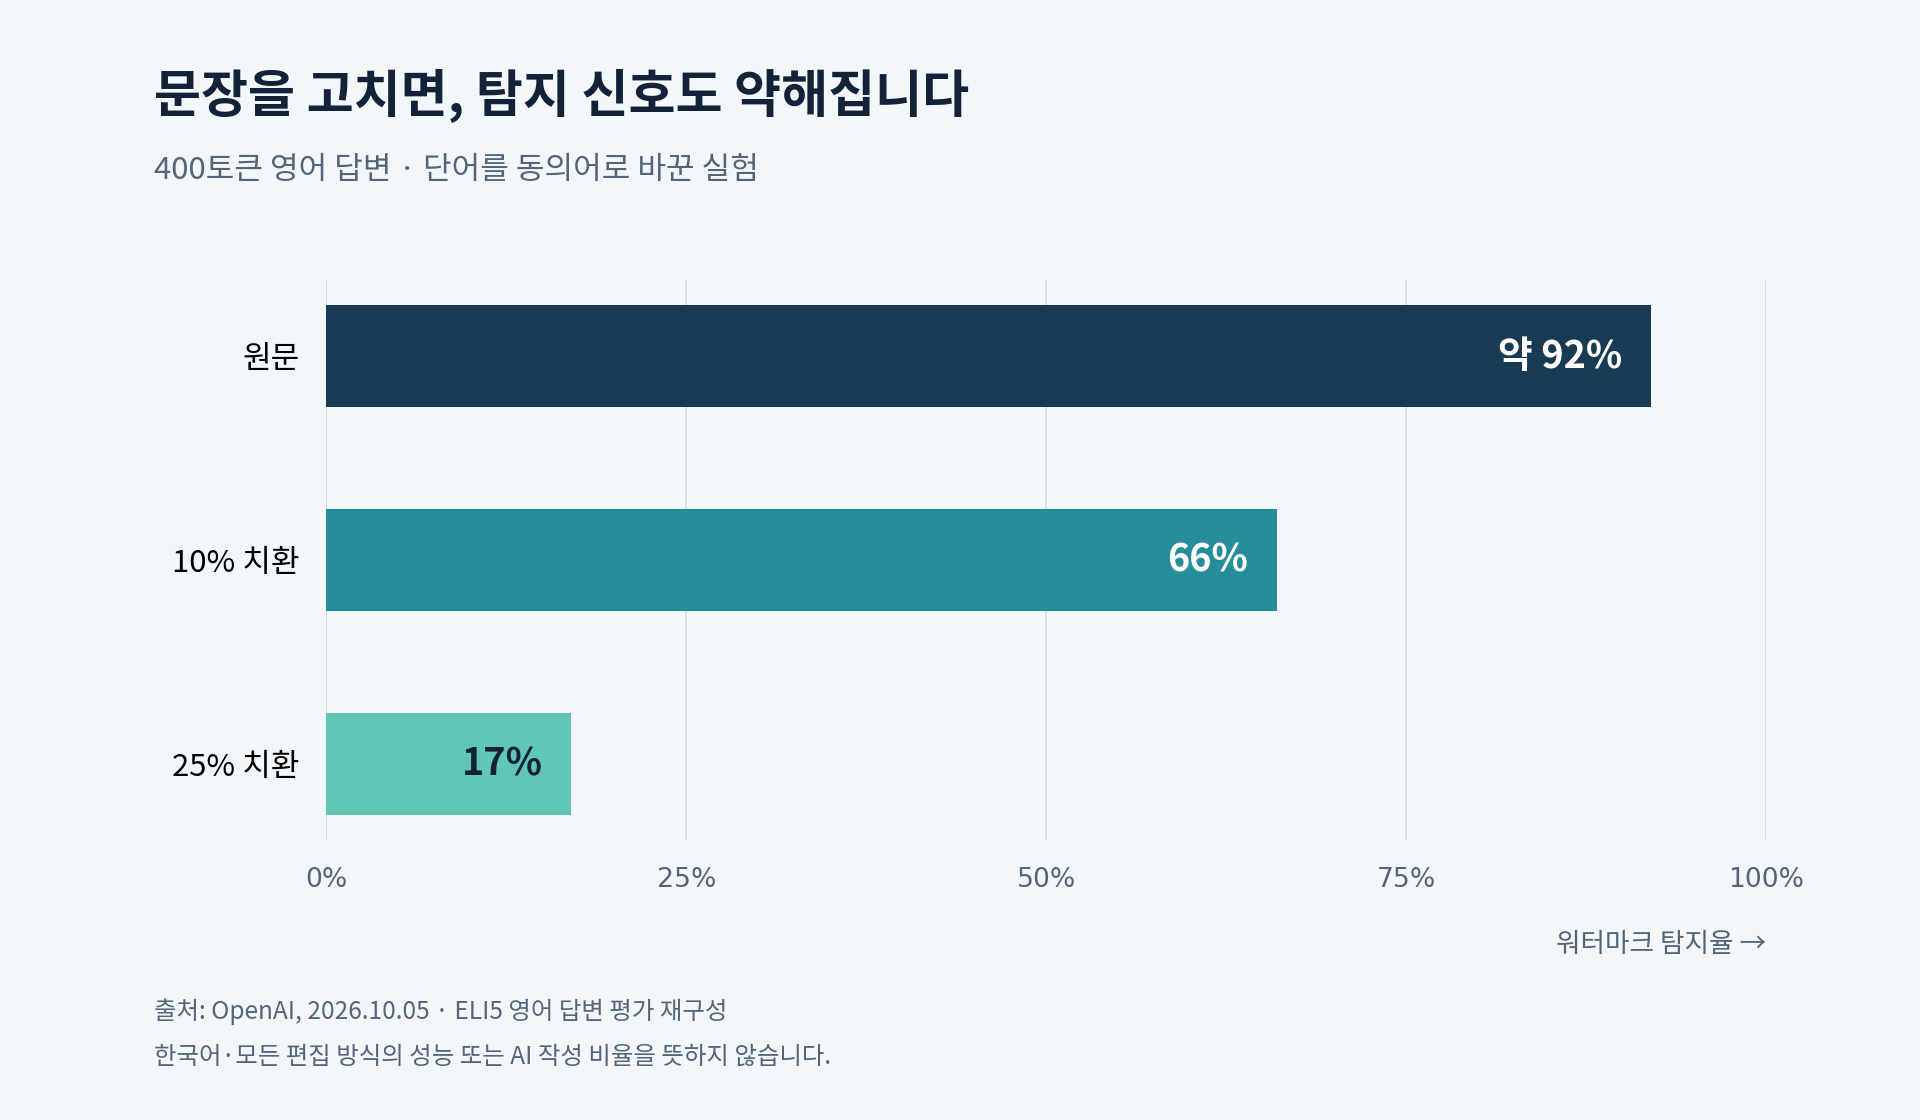
400토큰 영어 답변의 동의어 치환 실험. 원문 약 92%, 10% 치환 66%, 25% 치환 17%. 일반 문서의 정확도나 AI 작성 비율을 뜻하지 않습니다.
출처: OpenAI 발표 데이터 · VECTORLOG 재구성
OpenAI의 ELI5 영어 답변 평가를 재구성했습니다. 수치는 동의어 치환 실험의 탐지율이며, 글의 AI 작성 비율을 뜻하지 않습니다. 평가 조건과 원문
흔적이 있어도 사람의 기여를 계산할 수는 없습니다
탐지 결과는 OpenAI 시스템이 글의 일부를 생성하거나 처리했을 가능성에 관한 제한된 신호입니다. 사람이 얼마나 기획하고 고쳤는지, 내용이 사실인지, 누가 소유하거나 책임지는지, 어떤 사람이 썼는지까지 알려주지는 않습니다. 반대로 신호를 찾지 못했다고 사람이 쓴 글로 확정할 수도 없습니다. OpenAI 공식 설명
사람이 작성한 원고를 AI로 다듬는 장면을 떠올리면 이 구분이 선명해집니다. 문장에 AI의 개입 흔적이 있다고 해도, 글의 문제의식과 사례, 판단을 누가 만들었는지는 별도로 살펴야 합니다. 출처 신호 하나로 그 과정을 압축하기는 어렵습니다.
이 도구는 다른 회사 모델까지 포괄해 모든 AI 글을 가려내도록 설계되지 않았습니다. 또한 이번 발표에서 X 등에 글을 붙여 넣으면 노출이나 계정에 불이익이 생긴다는 결론을 끌어낼 근거도 없습니다. 특정 플랫폼의 운영 정책과 실제 적용 여부는 따로 확인할 사안입니다. 탐지 범위 설명
글을 만드는 과정은 여전히 중요합니다
블로그나 회사 콘텐츠를 만드는 입장에서 이번 발표를 읽는다면, 탐지 점수보다 먼저 남겨야 할 기록이 있습니다. 어떤 자료를 근거로 삼았는지, AI가 맡은 부분은 무엇인지, 최종 사실 확인과 판단은 누가 했는지입니다. 작성 과정이 남아 있어야 결과에 대한 질문에도 구체적으로 답할 수 있습니다.
textGrain은 글의 출처를 이해하는 데 쓸 수 있는 신호를 하나 더합니다. 그 신호의 적용 범위와 실패 조건까지 함께 읽는 일이 앞으로의 콘텐츠 검토에서 중요해질 것 같습니다.
- #OpenAI
- #textGrain
- #텍스트 워터마크
- #콘텐츠 출처
CONTINUE READING
이 기록에서 이어서 보기
VECTORLOG LETTER
다음 기록도 받아보고 싶다면 구독을 연결해 주세요.