AI 인프라
로그인까지 느려지는 공유 DB, OpenAI가 다시 설계한 작업 순서
발행일:
OpenAI의 Habitat 기술 공개를 바탕으로 공유 DB의 자원 경합, 저장소 분리의 운영 부담, 중요한 요청을 보호하는 우선순위 설계를 살펴봅니다.
부가 기능 하나가 바빠졌는데 로그인까지 영향을 받는다면 어디부터 봐야 할까요. OpenAI는 2026년 10월 23일 저장소 플랫폼 Habitat의 설계를 공개하며, 일부 기능의 부하가 로그인·가입 흐름을 방해했던 문제를 설명했습니다. 여러 작업이 같은 저장 자원을 나눠 쓰는 환경에서는 중요한 요청도 함께 밀릴 수 있습니다. OpenAI 공식 기술 글
따로 나누면 안전하지만, 관리할 것도 늘어납니다
OpenAI는 Azure Cosmos DB의 공유 컨테이너에서 출발해 중요한 서비스를 별도 컨테이너로 분리했습니다. 여기서 컨테이너는 데이터를 담고 처리 용량을 배정하는 단위입니다. 분리는 장애가 다른 기능으로 번지는 범위를 줄였지만, 각 팀이 출시 전 필요한 용량과 이후 증가량을 챙겨야 했습니다.
결국 공유 구조를 기본으로 되돌리면서, 부하가 몰린 키를 제한하고 대량 입력·추출 같은 작업의 우선순위를 낮췄습니다. 사용자가 기다리는 요청을 먼저 보호하도록 바꾼 것입니다. 이는 OpenAI와 Azure 팀의 공동 설계 사례이며, 같은 기능 묶음이 모든 고객에게 일반 제공됐다는 발표는 아닙니다.
총용량이 남아도 한쪽에 몰릴 수 있습니다
Microsoft 문서에서 RU는 데이터베이스 작업에 쓰이는 연산·메모리·입출력 자원을 나타내는 단위입니다. 요청 한 건을 무조건 1 RU로 세는 방식이 아닙니다. 또한 여러 논리 파티션이 하나의 물리 파티션을 공유합니다. 컨테이너 전체 용량만 볼 게 아니라, 특정 데이터에 요청이 집중되는지도 확인해야 합니다. RU 설명 · 파티션 구조
예를 들어 가상의 소규모 주문 관리 앱을 생각해보겠습니다. 직원이 지난달 주문을 한꺼번에 내려받는 동안 고객의 로그인이나 주문 조회가 같은 저장소 용량을 두고 경쟁할 수 있습니다. 이런 상황이라면 다운로드 완료 시간보다 고객 화면을 먼저 지키는 우선순위가 필요합니다. 별도 저장소를 둘지는 처리량뿐 아니라 관리할 사람과 비용까지 보고 결정해야 합니다. 이는 실제 고객 사례가 아닌 이해를 위한 예시입니다.
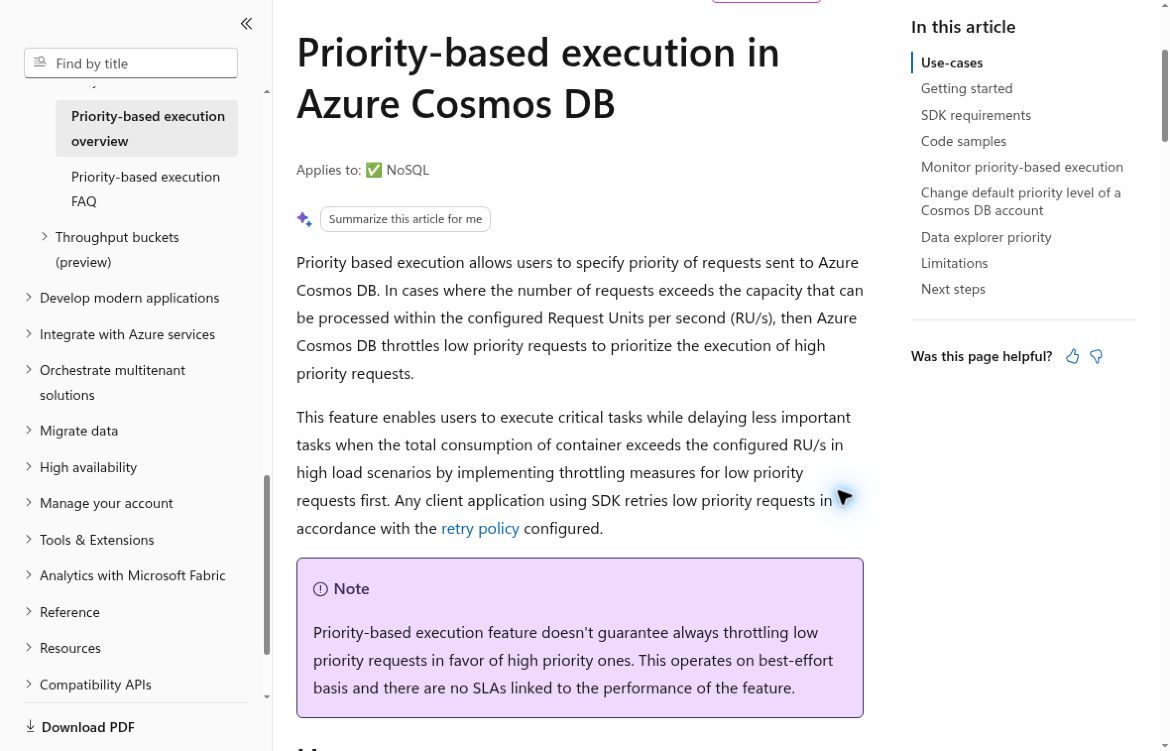
작동 원리 보조 자료: Microsoft Learn의 Azure Cosmos DB 문서 실제 화면. OpenAI 발표 화면이나 서비스 테스트 결과가 아닙니다. 2026년 10월 24일 한국시간 캡처, 이미지 내용 수정 없음. 원문 · 스크린샷 사용 조건. Used with permission from Microsoft.
우리 서비스에서는 무엇을 먼저 지킬까요
저는 이번 사례에서 DB를 몇 개로 나눴는지보다, 어떤 요청은 기다려도 되고 어떤 요청은 지켜야 하는지 정한 과정이 더 중요하게 보입니다. 작은 서비스라면 우선 세 가지만 확인해볼 만합니다.
- 로그인·주문 조회와 대량 내보내기가 같은 자원을 쓰는가?
- 부하가 커질 때 먼저 늦출 작업과 완료 시한이 정해져 있는가?
- 분리한 저장소의 용량과 장애를 누가 계속 관리할 것인가?
다만 우선순위 설정도 만능은 아닙니다. 공개된 Azure Cosmos DB의 우선순위 실행은 최선 노력 방식이며 성능 SLA를 보장하지 않습니다. 서버리스 계정은 지원하지 않고, 공유 처리량 데이터베이스에서는 동작이 비결정적일 수 있습니다. OpenAI 사례를 그대로 설정 가이드로 옮기기보다, 사용하는 계정과 SDK의 지원 조건부터 확인해야 합니다. 설정을 바꾼다면 핵심 요청의 지연과 대량 작업의 완료 시간도 함께 비교할 필요가 있습니다. 공식 지원 조건
저장소가 아니라 AI 추론 서버의 요청 배분이 고민이라면 llm-d 1.0의 요청 우선순위와 운영 조건도 함께 살펴볼 수 있습니다. 두 글은 처리 자원이 다르므로 같은 설정으로 해결되는 문제는 아닙니다.
썸네일은 AI로 제작한 개념 이미지이며 실제 OpenAI 또는 Azure UI가 아닙니다. 관련 상표는 해당 권리자 소유이며 제휴·후원을 뜻하지 않습니다.
저는 이번 사례에서 공유냐 분리냐를 먼저 고르기보다, 중요한 요청이 다른 작업 때문에 밀리는 경로부터 찾는 편이 낫다고 봅니다. 분리는 장애의 영향을 줄일 수 있지만 각 저장소의 용량과 운영 책임도 함께 늘어나기 때문입니다.
- #OpenAI
- #Habitat
- #Azure Cosmos DB
- #데이터베이스
CONTINUE READING
이 기록에서 이어서 보기
VECTORLOG LETTER
다음 기록도 받아보고 싶다면 구독을 연결해 주세요.