On-device AI
구글 EmbeddingGemma 2 공개, 사진·음성·코드를 내 기기에서 함께 찾습니다
발행일:
구글이 EmbeddingGemma 2를 공개했습니다. 문서와 코드, 사진·영상·음성을 같은 벡터 공간에서 검색하며, 텍스트 전용 270M부터 전체 740M까지 필요한 구성만 불러올 수 있습니다. 공개 파일과 라이선스, 벤치마크 변화, 메모리·입력 한도를 정리했습니다.
구글이 10월 6일 EmbeddingGemma 2를 공개했습니다. 문서와 코드, 이미지, 영상, 음성을 같은 벡터 공간에 담아 검색할 수 있는 경량 임베딩 모델입니다. 전체 구성은 740M, 텍스트와 코드만 쓰는 구성은 270M 파라미터이며, 스마트폰이나 노트북에서 실행하는 검색 기능을 겨냥했습니다. 구글 공식 발표
눈여겨볼 부분은 서로 다른 형식의 업무 자료를 한 검색 흐름으로 묶을 수 있다는 점입니다. 파일 이름이 기억나지 않는 사진, 회의 녹음, 예전 프로젝트의 코드도 내용과 의미를 기준으로 찾는 도구를 만들 수 있습니다. 다만 모델을 내려받았다고 이런 검색 서비스가 완성되지는 않습니다. 자료를 색인하고, 검색 결과를 보여주며, 필요한 경우 답변 생성 모델과 연결하는 작업이 남습니다.
이번에 실제로 공개된 것은 무엇인가요?
현재 Google의 Hugging Face 저장소에는 EmbeddingGemma 2의 모델 가중치와 설정, 토크나이저 파일이 올라와 있습니다. 확인 시점의 model.safetensors 파일은 약 1.49GB이고, 저장소와 공식 모델 카드 모두 라이선스를 Apache 2.0으로 표시합니다. 공개 예고에 그친 단계는 아닙니다. 모델 저장소와 파일 목록
필요한 인코더만 불러오는 방식이라 구성에 따라 모델 크기가 달라집니다.
- 270M: 텍스트와 코드
- 440M: 텍스트·코드에 이미지와 영상 프레임 추가
- 570M: 텍스트·코드에 음성·소리 추가
- 740M: 비전과 오디오 인코더를 모두 사용하는 전체 구성
텍스트 구성에 비전 170M, 오디오 300M을 더합니다. 네 구성은 같은 벡터 공간을 사용하므로 텍스트 검색어와 전체 구성의 자료를 비교할 수 있습니다. 개발자 가이드
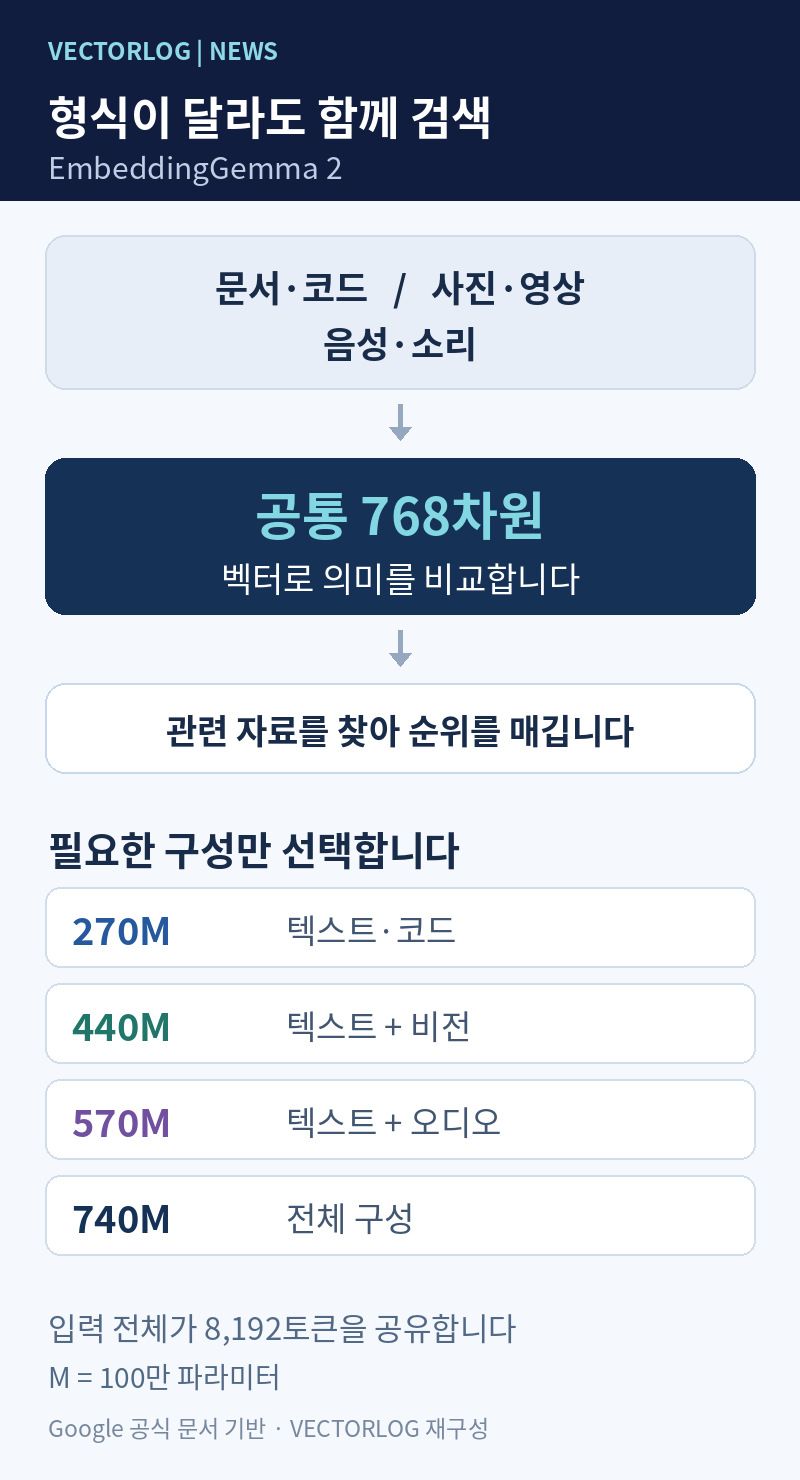
공식 개발자 가이드를 바탕으로 VECTORLOG 재구성. 영상은 샘플링한 프레임을 사용하며, 오디오까지 다루려면 해당 인코더가 필요합니다.
출처: 자료 Google · 시각화 VECTORLOG
업무에서는 어디에 쓸 수 있을까요?
임베딩은 자료의 의미를 숫자 배열로 표현하는 방식입니다. 검색어와 자료를 각각 숫자로 바꾼 뒤, 서로 얼마나 가까운지 비교해 관련 결과를 찾습니다. EmbeddingGemma 2는 이 과정을 여러 형식의 자료에 적용합니다. 구글 임베딩 활용 가이드
콘텐츠를 만드는 팀이라면 “비 오는 거리에서 찍은 제품 장면” 같은 설명으로 촬영 자료를 찾는 기능을 생각해 볼 수 있습니다. 개발팀은 함수 이름을 정확히 몰라도 동작을 설명해 관련 코드를 찾는 검색을 검토할 수 있습니다. 회의 자료를 다루는 도구라면 메모, 화면 캡처, 음성을 함께 검색하는 방식도 가능합니다. 이는 모델의 지원 범위에서 생각해 볼 수 있는 활용 예시이며, 각 업무에서의 정확도는 별도 확인이 필요합니다.
구글은 실제 참고 앱으로 AI Edge Gallery의 Instant Media Search와 Video Moments Finder를 소개했습니다. 자연어로 로컬 이미지나 영상을 찾고, 영상에서 관련 시점을 찾는 데모입니다. Mac용 실험 앱 Foresight는 EmbeddingGemma 2와 Gemma 4를 연결해 회의 기록과 개인 자료 검색에 활용합니다. Google AI Edge 발표
검색 결과를 문장으로 정리하려면 생성 모델이 추가로 필요합니다. RAG를 만들 때 EmbeddingGemma 2는 관련 자료를 찾는 쪽에 쓰이고, 답변 작성은 Gemma 4 같은 생성 모델이 맡는 구조입니다. 이 구분을 알아두면 검색 모델의 개선을 곧바로 답변의 정확도 향상으로 해석하는 일을 줄일 수 있습니다.
코드 검색은 개선됐고 다국어 텍스트는 비슷한 수준입니다
구글이 공개한 768차원 원본 체크포인트 평가에서 MTEB Code 점수는 이전 모델의 68.76에서 78.68로 9.92포인트 올랐습니다. 다국어 MTEB 점수는 61.15에서 61.36으로 비슷한 수준입니다. 따라서 이번 변화는 모든 텍스트 검색 성능의 큰 상승으로 묶기보다, 코드 검색 개선과 멀티모달 지원 확대를 중심으로 보는 편이 정확합니다. 공식 모델 카드
이 수치는 구글이 공개한 벤치마크 결과입니다. 한국어 사내 문서, 고유한 상품명, 복잡한 표와 도표에서도 같은 개선 폭이 나온다고 보장하지는 않습니다. 실제 도입 판단에는 자주 하는 질문과 정답 자료를 묶어 검색 결과의 상위 몇 개 안에 필요한 자료가 나오는지 확인하는 과정이 필요합니다.
메모리와 입력 한도는 조건을 함께 봐야 합니다
공식 발표의 약 191MB와 567MB 메모리 수치는 Google Pixel 11 Pro에서 양자화를 적용했을 때의 텍스트 전용 및 전체 구성 수치입니다. 모든 노트북과 스마트폰에서 같은 메모리로 실행된다는 뜻으로 읽어서는 안 됩니다. 구글 공식 발표
LiteRT 배포 모델은 별도의 양자화 파일을 제공합니다. 성능 문서도 운영체제마다 메모리 측정 방식이 다르며, 일부 측정에는 가속기 메모리가 포함되지 않는다고 명시합니다. 다운로드 파일 크기, 모델 실행 메모리, 검색용 색인이 차지하는 공간은 나누어 계산하는 편이 좋습니다. LiteRT 모델과 측정 조건
입력 한도 역시 형식별로 따로 주어지지 않습니다. 모든 입력이 8,192토큰을 함께 사용합니다. 기본 설정에서 한 종류만 넣는다면 이미지 약 29장, 영상 약 58프레임, 오디오 약 327초가 상한의 예시입니다. 텍스트나 다른 미디어를 함께 넣으면 각 형식에 쓸 수 있는 양은 줄어듭니다. 긴 회의나 영상을 검색하려면 구간을 나누고 원본 시간 정보를 연결하는 설계가 필요합니다. 공식 모델 카드의 입력 한도
처음 붙일 때 확인할 설정입니다
- 필요한 형식만 불러옵니다. 문서와 코드 검색부터 시작한다면 비전·오디오 인코더를 끈 270M 구성을 검토할 수 있습니다. Sentence Transformers의 기본 로딩은 전체 구성이므로 설정을 확인해야 합니다.
- Sentence Transformers로 실행할 때는 bfloat16 또는 float32를 사용합니다. 공식 문서는 float16에서 잘못된 값이나 품질 저하가 발생할 수 있다고 경고합니다. 실행·정밀도 안내
- 검색어와 자료에 맞는 작업 프롬프트를 적용합니다. 일반 검색, 코드 검색, 유사도 비교는 목적이 다릅니다. 작업별 프롬프트 안내
- 차원을 줄였다면 다시 정규화하고 검색어와 색인의 차원을 맞춥니다. 768→128차원은 같은 자료형의 벡터만 6분의 1로 줄어드는 계산입니다. 전체 데이터베이스 절감률은 다르며, 128차원의 멀티모달 품질을 확인해야 합니다. 차원 축소 가이드
온디바이스 구성의 장점을 살리려면 원본 파일과 색인뿐 아니라 로그, 동기화, 답변 생성 단계의 데이터 흐름도 함께 살펴봐야 합니다. 임베딩 계산을 기기 안에서 했다는 사실만으로 앱 전체의 데이터 처리가 로컬에 머무는 것은 아닙니다.
지금 시작할 수 있는 범위를 구분하면 좋습니다
현재 가중치·Python 가이드·LiteRT 파일은 공개됐고, 개발자 가이드는 Sentence Transformers 6.1.0 이상을 안내합니다. Android ML Kit 통합은 발표 기준으로 향후 몇 주 내 제공 예정입니다. 개발자 가이드 · Google AI Edge 일정
이번 공개는 자료가 많은 팀에 작은 실험을 해볼 이유를 줍니다. 자주 찾는 문서나 촬영 자료 한 묶음에서 시작해, 키워드 검색으로 놓치던 결과를 얼마나 더 찾는지 확인해 볼 만합니다. 필요한 자료를 더 빨리 찾을 수 있는지, 그 검색을 원하는 기기와 데이터 처리 범위 안에서 운영할 수 있는지가 도입의 기준입니다.
자료 확인: 2026년 10월 7일 한국시간. 구글 공식 발표, 개발 문서와 공개 모델 저장소를 기준으로 정리했습니다.
- #EmbeddingGemma 2
- #온디바이스 AI
- #멀티모달
- #임베딩
- #RAG
CONTINUE READING
이 기록에서 이어서 보기
VECTORLOG LETTER
다음 기록도 받아보고 싶다면 구독을 연결해 주세요.