AI Workflow
AI를 많이 쓰기 시작하면 모델 선택 기준이 성능에서 작업 경제성으로 바뀐다
발행일:
AI를 가끔 쓸 때는 가장 강한 모델을 고르면 된다고 생각하기 쉽다. 하지만 바이브코딩과 문서·기획 작업에 여러 모델을 반복적으로 사용하다 보니, 실제 선택 기준은 결과물의 품질만으로 끝나지 않았다. 응답 속도, 토큰 소모, 재시도 횟수, 마지막 검토 부담까지 합쳐서 봐야 했다.
처음에는 모델 선택이 꽤 단순하다고 생각했다.
가장 좋은 결과를 내는 모델을 쓰면 된다고 봤다.
특히 바이브코딩처럼 결과물의 완성도가 눈에 바로 보이는 작업에서는 더 그랬다. 복잡한 수정이나 구조를 다루는 작업일수록 강한 모델을 먼저 찾게 됐다.
그런데 AI를 계속 쓰다 보니 기준이 조금씩 달라졌다.
결과가 좋은 것만으로는 부족했다.
얼마나 빨리 답이 오는지, 같은 작업을 몇 번 다시 시켜야 하는지, 토큰을 얼마나 쓰는지, 마지막에 내가 얼마나 많이 손봐야 하는지가 점점 더 중요하게 느껴졌다.
AI를 많이 쓰기 시작하면 모델 선택은 성능 비교보다 작업 경제성의 문제가 된다.
가장 좋은 모델이 항상 가장 좋은 선택은 아니었다
복잡한 작업에서는 확실히 더 높은 수준의 모델이 유리하게 느껴지는 순간이 있었다.
한 번에 더 좋은 구조를 만들거나, 내가 원하는 방향을 더 빨리 이해하는 경우도 있었다.
하지만 반복 작업에서는 이야기가 달랐다.
결과는 좋지만 응답이 느리거나, 토큰을 많이 쓰거나, 사소한 수정까지 계속 강한 모델로 처리하는 방식이 항상 효율적이라고 느껴지지는 않았다.
반대로 처음부터 최고 수준의 결과가 필요하지 않은 작업도 꽤 많았다.
문서 초안을 정리하거나, 이미 정해진 구조 안에서 내용을 다듬거나, 비교적 단순한 수정을 반복하는 일에서는 굳이 가장 강한 모델을 계속 쓸 이유가 없었다.
이때부터 나는 모델을 하나 고르는 대신 작업마다 다른 수준의 모델을 배치하는 쪽으로 생각하기 시작했다.
내가 보게 된 것은 성능이 아니라 ‘완료 비용’이었다
여기서 말하는 작업 경제성은 단순히 API 가격이나 구독료만 뜻하지 않는다.
내가 실제로 더 많이 보게 된 것은 이런 것들이었다.
응답이 얼마나 빠른가.
한 번에 원하는 결과에 얼마나 가까이 가는가.
같은 작업을 몇 번 다시 요청해야 하는가.
중간에 내가 설명을 얼마나 다시 해야 하는가.
마지막 결과를 사람이 얼마나 많이 고쳐야 하는가.
이 요소들을 합쳐서 보면 가장 강한 모델이 항상 가장 경제적인 모델은 아니었다.
겉으로는 한 번의 요청이 비싸 보여도 재작업이 적다면 오히려 나을 수 있고, 반대로 빠르고 가벼운 모델이라도 같은 작업을 여러 번 반복해야 한다면 체감 효율은 떨어질 수 있었다.
그래서 지금은 모델의 가격표보다 업무 하나를 끝낼 때까지 들어가는 전체 비용을 더 많이 생각하게 됐다.
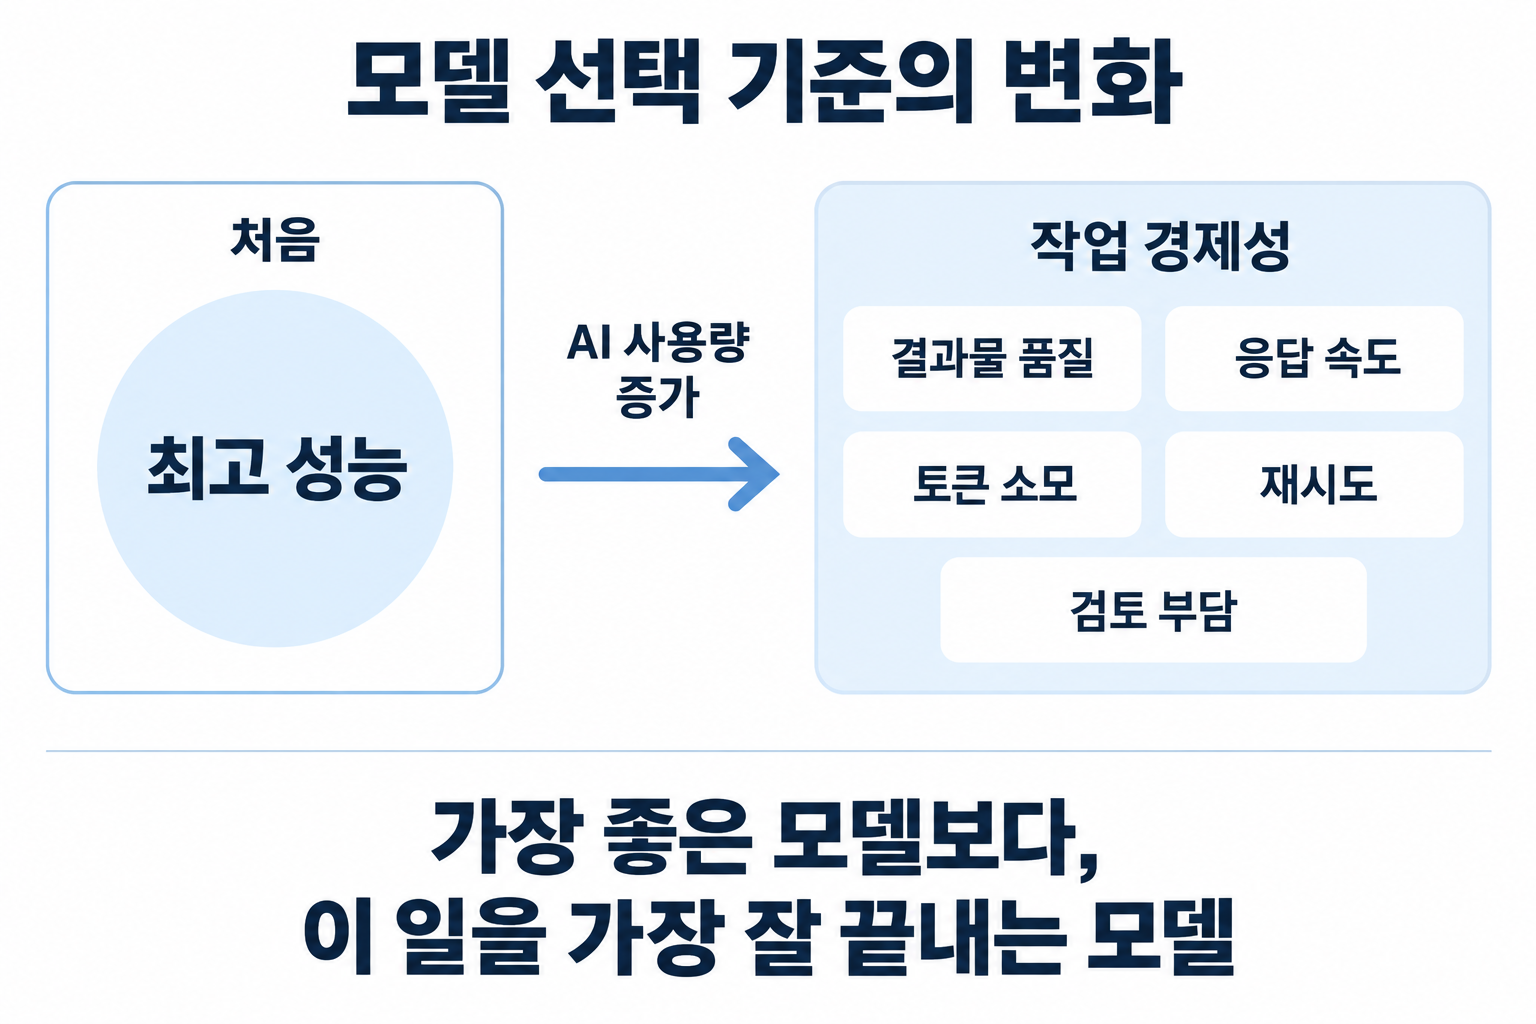
AI 모델 선택 기준을 ‘최고 성능’ 중심과 ‘작업 경제성’ 중심으로 비교해 보여주는 개념 다이어그램.
| 기준 | 확인할 질문 |
|---|---|
| 결과물 품질 | 한 번에 원하는 결과에 얼마나 가까운가? |
| 응답 속도 | 반복 작업에서 기다리는 시간이 부담이 되는가? |
| 토큰 소모 | 작업을 반복할수록 사용량 부담이 커지는가? |
| 재시도 | 원하는 결과를 얻기 위해 몇 번 다시 요청해야 하는가? |
| 검토 부담 | 사람이 마지막에 얼마나 많이 확인하고 수정해야 하는가? |
| 실패 비용 | 잘못된 결과가 나왔을 때 다시 처리하기 어려운 작업인가? |
바이브코딩에서는 이 차이가 더 크게 느껴졌다
바이브코딩을 하다 보면 한 번의 요청으로 작업이 끝나는 경우가 많지 않다.
코드를 만들고, 확인하고, 오류를 찾고, 다시 수정하고, 결과를 보면서 방향을 바꾼다.
그 과정에서 모델을 계속 호출한다.
이런 작업에서는 작은 차이가 반복될수록 크게 느껴진다.
복잡한 구조를 처음 잡거나 원인을 찾기 어려운 오류를 다룰 때는 더 강한 모델을 쓰는 편이 마음이 편했다.
하지만 이미 방향이 정해진 뒤 세부 수정이나 반복적인 정리를 할 때까지 같은 수준의 모델을 계속 쓰는 것은 점점 비효율적으로 느껴졌다.
그래서 한 모델로 처음부터 끝까지 처리하기보다 작업의 난이도에 따라 모델을 바꾸고, 결과가 부족한 부분만 더 강한 모델로 다시 처리하는 방식이 자연스러워졌다.
이건 어떤 모델이 절대적으로 우수하다는 판단과는 다르다.
오히려 모델 선택도 workflow의 일부가 됐다는 쪽에 가깝다.
문서 작업에서도 같은 일이 생겼다
코딩만 그런 것은 아니었다.
문서 초안을 만들고, 내용을 정리하고, 기획안을 다듬을 때도 비슷했다.
초기 아이디어를 넓게 펼치는 단계와 최종 문장을 다듬는 단계는 필요한 능력이 다르다.
복잡한 자료를 읽고 구조를 잡는 작업과 이미 정리된 내용을 짧게 요약하는 작업도 같다.
그런데 처음에는 이 모든 일을 하나의 모델에게 맡기는 경우가 많았다.
AI를 많이 사용하면서부터는 오히려 작업을 쪼개서 어떤 단계에 어느 정도의 모델이 필요한지 보는 습관이 생겼다.
중요한 판단이나 어려운 문제에는 더 많은 능력을 쓰고, 반복적이고 예측 가능한 작업에는 필요한 만큼만 쓴다.
사람이 일할 때도 모든 업무에 같은 수준의 집중력을 쓰지 않는 것과 비슷하다.
모델 선택의 기준도 업무 단계에 따라 달라진다
지금은 모델을 볼 때 단순히 ‘누가 더 똑똑한가’를 먼저 묻지 않는다.
대신 이런 질문을 한다.
이 작업은 실패했을 때 다시 하는 비용이 큰가?
처음부터 높은 완성도가 필요한가?
속도가 중요한가?
반복 호출이 많은 작업인가?
결과를 사람이 쉽게 검토할 수 있는가?
잘못된 결과를 발견하기 어려운 작업인가?
이 질문에 따라 필요한 모델의 수준도 달라진다.
예를 들어 결과를 바로 눈으로 확인할 수 있고 다시 실행하기 쉬운 작업이라면 가벼운 모델을 먼저 써볼 수 있다.
반대로 잘못된 결과를 찾기 어렵거나, 한번 잘못 설계하면 이후 작업 전체가 꼬일 수 있는 일이라면 처음부터 더 강한 모델을 쓰는 편이 나을 수 있다.
결국 모델 선택은 단순한 성능 순위가 아니라 실패 비용과 검토 가능성까지 포함한 업무 설계 문제가 된다.
최고 성능보다 중요한 것은 ‘이 일에 충분한가’였다
AI 모델을 비교하다 보면 자연스럽게 최고 성능에 눈이 간다.
나도 그랬다.
하지만 사용량이 많아질수록 질문이 조금 바뀌었다.
‘어떤 모델이 가장 좋은가?’보다
‘이 일을 끝내는 데 이 모델이면 충분한가?’
를 더 많이 묻게 됐다.
충분하다면 굳이 더 무거운 선택을 할 필요가 없다.
반대로 반복 수정과 검토가 계속 생긴다면 처음부터 더 강한 모델을 쓰는 편이 전체적으로 나을 수도 있다.
여기에는 하나의 정답이 없다.
업무 종류도 다르고, 사람이 AI 결과를 검토할 수 있는 능력도 다르고, 속도와 비용을 얼마나 중요하게 보는지도 다르기 때문이다.
그래서 나는 특정 모델을 항상 우선하는 방식보다 업무의 성격에 따라 모델을 배치하는 방식이 더 현실적이라고 느낀다.
AI를 많이 쓴다는 것은 결국 운영의 문제다
AI를 가끔 사용할 때는 모델의 성능 차이가 가장 먼저 보인다.
하지만 하루 동안 여러 번 호출하고, coding과 문서 작업을 오가고, 반복적인 업무까지 맡기기 시작하면 다른 것이 보이기 시작한다.
모델을 호출하는 횟수가 늘어나고, 수정과 검토가 반복되고, 여러 단계의 workflow 안에 AI가 들어온다.
그때부터는 한 번의 답변 품질보다 전체 작업이 어떻게 끝나는지가 더 중요해진다.
나도 지금은 가장 강한 모델 하나를 찾는 것보다, 어떤 작업을 어느 수준의 모델에 맡길 것인가를 더 많이 고민한다.
결국 AI를 많이 쓴다는 것은 좋은 모델을 찾는 문제에서 끝나지 않는다.
그 모델들을 어떻게 배치하고, 언제 더 강한 모델을 쓰고, 어디에서 사람의 검토를 넣을지 결정하는 운영의 문제가 된다.
모델 선택도 이제 workflow 설계의 일부다.
- #AI
- #AI Workflow
- #AI 모델
- #바이브코딩
- #업무 생산성
CONTINUE READING
이 기록에서 이어서 보기
VECTORLOG LETTER
다음 기록도 받아보고 싶다면 구독을 연결해 주세요.
WORK TOGETHER
함께 일해볼까요?
AI 활용, 웹사이트·콘텐츠, 디지털 마케팅에 관한 프로젝트나 협업 이야기, 편하게 연락 주세요.