AI Coding
AI 코드 리뷰, 고친 뒤에는 무엇을 확인할까?
발행일: · 수정일:
AI가 코드에서 문제를 찾고, 수정안까지 내놓으면 작업이 거의 끝난 것처럼 보입니다. 하지만 수정한 코드가 원래 문제를 해결했는지, 다른 기능에 영향을 주지는 않았는지 확인하는 일은 남아 있습니다. 리뷰 의견에 ‘해결됨’ 표시가 붙는 순간에도 그 판단의 근거를 살펴봐야 합니다.
GitHub의 최근 발표는 이 과정을 두 방향에서 다룹니다. 9월 18일 Copilot 업데이트는 리뷰와 후속 수정을 연결했고, 10월 5일 공개한 ReviewBench는 AI 리뷰의 품질을 비교할 기준을 제시했습니다. 두 소식을 함께 보면 AI 코딩 도구를 고를 때 무엇을 확인해야 할지 조금 더 구체적으로 보입니다.
다음 커밋까지 이어지는 리뷰
Copilot Code Review는 후속 리뷰에서 수정된 의견을 해결 상태로 처리하고, 아직 남은 피드백은 열린 상태로 유지합니다. 리뷰 과정에서 셸 도구로 변경 사항을 검증할 수 있고, Lite 리뷰는 여러 에이전트의 발견을 결합합니다. GitHub의 9월 18일 발표
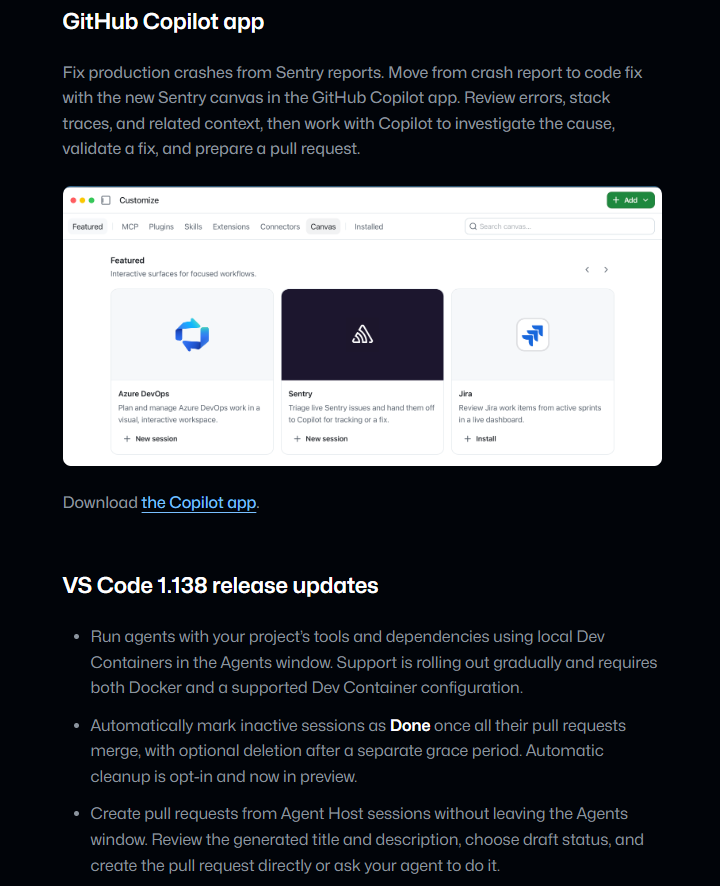
후속 리뷰에서 해결된 의견과 남은 피드백을 구분하는 Copilot 업데이트 안내입니다.
출처: GitHub
이 변화가 유용한 지점은 다음 작업을 고르는 순간입니다. 같은 변경을 여러 차례 검토할 때 이전 의견을 처음부터 다시 읽는 대신, 해결된 항목과 남은 항목을 나눠볼 수 있습니다. 다만 상태 표시는 검토를 돕는 정보입니다. 실제 동작을 확인할 테스트와 변경을 승인할 기준은 작업 안에 함께 있어야 합니다.
셸 도구를 쓴다는 설명도 그 범위 안에서 읽어야 합니다. 해당 주간 발표만으로 모든 테스트가 자동 실행된다거나 모든 실행 환경을 지원한다고 볼 수는 없습니다. 적용할 때는 어떤 명령을 실행했는지, 실패한 검사는 없었는지, 아예 확인하지 못한 영역은 어디인지 살펴볼 필요가 있습니다.
발견한 문제의 품질
리뷰 의견이 늘면 사람이 읽고 판단할 분량도 늘어납니다. 실제 오류를 찾은 의견과 사소한 스타일 제안이 한꺼번에 쌓이면, 개수만 보고 도구의 성능을 판단하기 어렵습니다.
GitHub가 공개한 ReviewBench 연구 프리뷰는 19개 언어의 공개 풀 리퀘스트(PR) 219개를 평가에 사용합니다. 정밀도는 지적한 문제 중 유효한 문제의 비율이고, 재현율은 알려진 유효한 문제 중 찾아낸 비율입니다. 결과를 심각도와 문제 유형별로 나눠볼 수도 있습니다. ReviewBench 공식 발표
이 구분을 팀의 작업에 대입해볼 수 있습니다. 검토 인원이 적은 팀은 불필요한 알림을 줄이는 데 무게를 둘 수 있고, 놓쳤을 때 피해가 큰 변경은 넓게 탐색한 결과를 더 꼼꼼히 살펴야 할 수 있습니다. 어느 쪽이든 ‘댓글을 많이 남겼다’는 사실만으로는 선택하기에 부족합니다.
같은 기준으로 비교하기
벤치마크의 정답 목록도 완전하지는 않습니다. 리뷰 도구가 기존 목록에 없던 유효한 문제를 발견할 수 있기 때문입니다.
ReviewBench는 기존 기준 집합으로 계산하는 grounded 지표와 새 발견까지 판정하는 augmented 지표를 구분합니다. 후자는 발견 내용에 따라 재현율의 분모가 시스템마다 달라지므로, GitHub는 시스템 간 대표 비교에 grounded recall을 사용합니다. Augmented 지표는 각 시스템을 더 살펴보는 보조 자료로 제시합니다.
순위표를 볼 때는 어떤 기준으로 정렬했는지부터 확인하는 편이 좋습니다. 중요한 오류를 찾는 능력과 자잘한 문제까지 폭넓게 짚는 능력을 같은 숫자로 뭉치면, 정작 우리 작업에서 필요한 차이를 놓칠 수 있습니다. 공개 PR에서의 점수가 자체 저장소에서도 이어지는지는 별도로 확인할 일입니다.
다중 모델 실험의 의미
GitHub는 여러 모델의 독립 실행을 결합한 Lite 계층 실험도 공개했습니다. 운영 환경 대조군 대비 addressed rate는 8.0% 높아졌고 리뷰당 비용은 8.0% 낮아졌습니다. 두 수치는 모두 상대적 변화입니다.
여기서 addressed rate는 리뷰 의견이 개발자의 코드 변경으로 이어졌는지를 LLM으로 판단한 비율입니다. 독립적으로 검증한 버그 탐지 정확도와는 구분해야 합니다. 이 결과를 9월에 발표한 모든 기능의 효과나 모든 저장소에서의 개선으로 확대할 수도 없습니다.
실무에서 참고할 부분은 실험의 확인 방식입니다. 벤치마크에서 좋아진 결과가 실제 운영에서도 같은 방향으로 나타나는지 대조했습니다. 우리 팀에서도 도구를 바꾸기 전후의 점수만 비교하기보다, 어떤 종류의 발견이 늘었고 사람이 검토하는 데 얼마의 시간이 들었는지 함께 기록하면 판단할 근거가 생깁니다.
수정 뒤에 남길 기록
앞의 발표를 실제 작업에 적용한다면, 리뷰부터 재확인까지 이어지는 기록을 남기는 방식으로 시작할 수 있습니다. 아래 그림은 그 흐름을 정리한 개념도입니다.
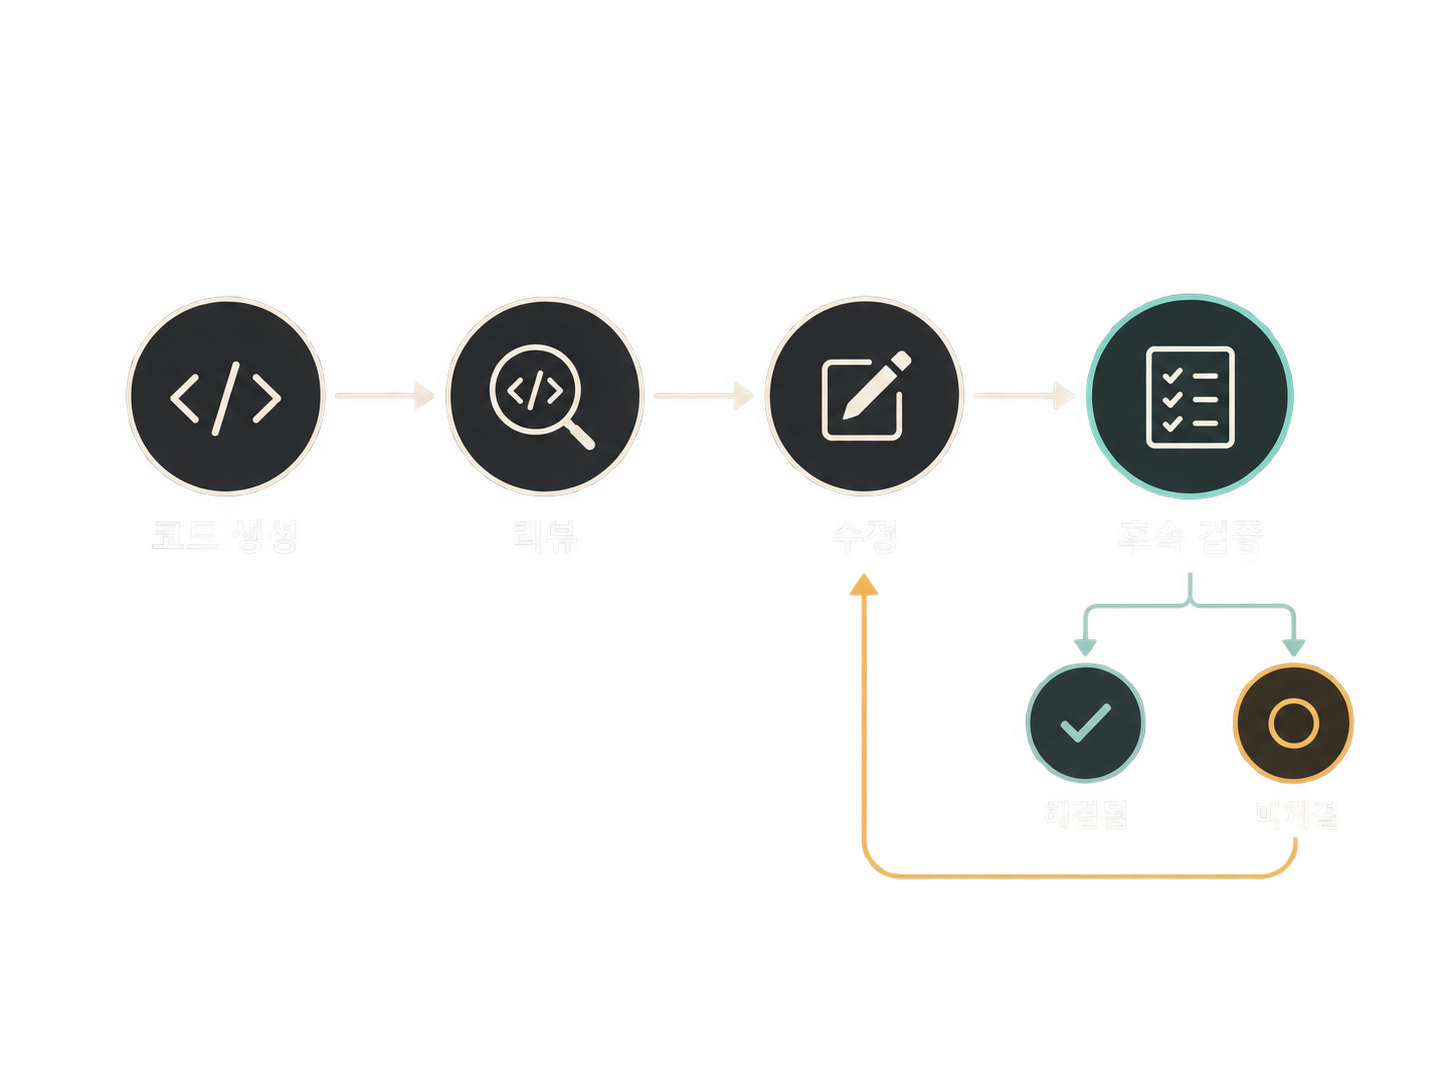
VECTORLOG 개념도. 코드 생성 이후 리뷰에서 문제를 발견하고 수정한 뒤, 후속 리뷰에서 해결 여부를 다시 확인하는 흐름을 정리한다.
출처: VECTORLOG
가령 AI가 입력값 처리의 오류를 지적해 코드를 고쳤다고 해보겠습니다. 해당 입력에서 문제가 사라졌는지 확인하는 것에 더해, 정상 입력과 경계 조건에서도 기대한 동작이 유지되는지 점검할 수 있습니다. 이런 확인 과정이 기록돼야 다음 검토자도 ‘고쳤다’는 보고를 검증할 수 있습니다.
팀에서 남길 항목은 복잡할 필요가 없습니다.
- 발견한 문제와 그 문제가 영향을 주는 동작
- 문제를 고친 커밋과 다시 실행한 테스트
- 해결됐다고 판단한 근거와 아직 확인하지 못한 범위
- 최종 변경을 검토한 사람과 추가 확인이 필요한 항목
이는 GitHub의 필수 설정 목록이 아니라, 발표 내용을 바탕으로 제안하는 검토 방식입니다. 테스트 실패를 숨긴 채 완료 상태만 남기거나, 같은 오류가 다음 수정에서 다시 나타나는 일을 알아차리려면 결과뿐 아니라 확인 과정도 볼 수 있어야 합니다.
작은 변경부터 확인하기
AI 리뷰 도구를 도입할 때는 실제 변경 몇 건을 골라 사람의 검토와 나란히 비교해볼 수 있습니다. 유효했던 발견, 놓친 문제, 다시 읽을 필요가 없었던 의견, 검토에 걸린 시간을 함께 적어보는 식입니다. 이를 통해 도구가 시간을 줄여주는 구간과 사람이 더 주의해야 할 구간을 구별할 수 있습니다.
Copilot의 후속 리뷰는 수정 상태를 추적하는 데, ReviewBench는 리뷰 도구의 특성을 살펴보는 데 각각 참고할 수 있습니다. 최종적으로 필요한 근거는 우리 코드에서 문제가 해결됐다는 확인입니다. AI가 남긴 의견을 다음 커밋과 테스트 결과까지 연결해두면, 변경을 받아들일지 결정하기가 한결 수월해집니다.
이 글은 2026년 9월 18일과 10월 5일 GitHub 공식 발표를 바탕으로 재구성한 해설입니다. 직접 사용한 후기나 독립적인 성능 검증 결과는 포함하지 않았습니다.
- #GitHub Copilot
- #AI Coding
- #Code Review
- #AI Agent
- #Verification
CONTINUE READING
이 기록에서 이어서 보기
VECTORLOG LETTER
다음 기록도 받아보고 싶다면 구독을 연결해 주세요.