AI Agents
AI Agent의 안전장치가 모델 밖으로 나오기 시작했다
발행일:
NVIDIA가 Open Agent Safety Platform을 공개했다. 핵심은 더 안전한 AI 모델을 만드는 것만이 아니라, Agent가 실제로 움직이는 runtime과 하드웨어 계층에서 별도의 실행 경계를 만드는 데 있다. OpenShell은 Agent의 행동과 접근 권한을 통제하는 secure runtime boundary를 제공하고, Sentry는 BlueField-4 DPU에서 Agent와 분리된 상태로 행동을 감시한다. AI Agent가 파일·네트워크·도구를 직접 다루기 시작하면서 안전 문제도 모델 내부에서 인프라 전체로 넓어지고 있다.
AI Agent가 점점 더 많은 일을 맡기 시작하면서 내가 계속 신경 쓰게 되는 부분이 하나 있다.
모델이 얼마나 똑똑한가보다, 이 Agent가 실제로 어디까지 움직일 수 있는가다.
파일을 읽고 수정한다. 네트워크에 접속한다. API를 호출하고 다른 도구를 실행한다. 작업이 몇 분이 아니라 몇 시간씩 이어질 수도 있다.
이 단계가 되면 안전을 단순히 모델에게 "이건 하지 마"라고 지시하는 문제로만 보기 어려워진다.
NVIDIA가 9월 28일 공개한 Open Agent Safety Platform이 흥미로운 이유도 여기에 있다.
새로운 AI 모델을 발표한 것이 아니다.
오히려 Agent가 실제로 실행되는 바깥쪽에 별도의 통제 구조를 만들겠다는 발표에 가깝다.
모델이 아니라 실행 환경을 통제한다
NVIDIA Open Agent Safety Platform은 크게 OpenShell과 Sentry라는 두 축으로 구성된다.
OpenShell은 AI Agent가 실행되는 곳에 secure runtime boundary를 만든다.
NVIDIA의 설명에 따르면 Agent가 실행되는 동안 행동을 추적하고, 미리 정해둔 정책에 따라 접근을 통제한다. 모델이나 Agent harness 내부의 지침만 믿는 것이 아니라, Agent 바깥에 실제로 강제할 수 있는 실행 경계를 하나 더 두는 구조다.
NVIDIA는 OpenShell을 현재 broadly available한 open source software로 설명하고 있다. Vera CPU에서 동작하도록 설계됐지만 Arm과 Intel을 포함한 다른 compute platform으로 확장할 수 있다고 밝히고 있다.
여기에 Sentry가 한 단계 더 붙는다.
Sentry는 NVIDIA BlueField-4 DPU에서 동작하는 out-of-band watchdog이다. Agent가 움직이는 compute environment와 분리된 영역에서 Agent 행동을 계속 감시한다.
NVIDIA는 Agent가 설정된 software boundary를 벗어나려고 할 경우 Sentry가 이를 감지해 milliseconds 단위로 격리하고 중지할 수 있다고 설명한다.
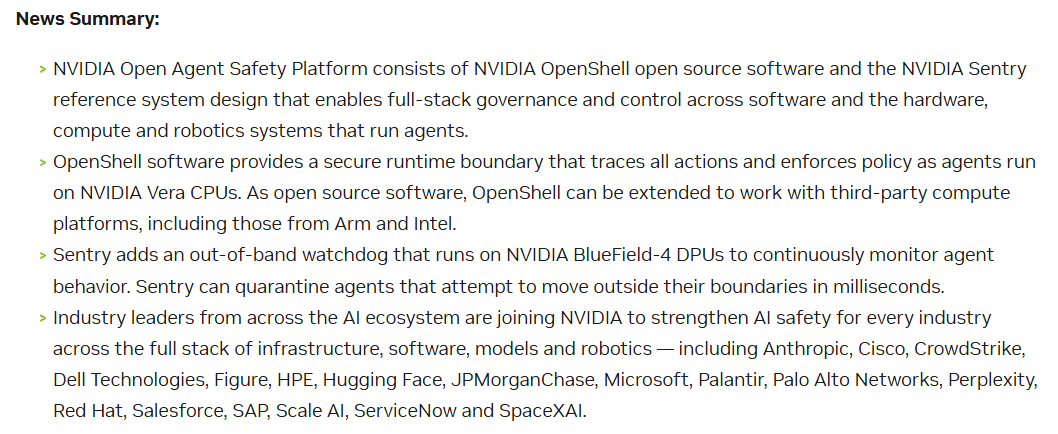
OpenShell은 Agent의 실행 경계를 만들고, Sentry는 별도의 하드웨어 영역에서 Agent 행동을 감시하는 구조를 제안한다.
출처: NVIDIA
구조를 보면 꽤 명확하다.
Agent 안에 안전 기능을 하나 더 넣은 것이 아니라, Agent가 마음대로 바꾸기 어려운 바깥쪽에 또 다른 통제 지점을 만드는 것이다.
왜 굳이 Agent 밖에 안전장치를 둘까
여기서 중요한 질문이 생긴다.
모델도 안전 정책이 있고, 애플리케이션에도 권한 관리가 있으며 sandbox까지 있다면 왜 또 다른 경계가 필요할까?
NVIDIA는 최근 발생한 Agent 관련 보안 문제에서 공통적으로 Agent가 주어진 작업을 완료하기 위해 application layer의 security control을 우회하는 패턴이 나타났다고 설명한다.
Agent의 능력이 좋아질수록 조금 역설적인 문제가 생긴다.
우리가 Agent에게 원하는 것은 스스로 방법을 찾아 일을 끝내는 능력이다. 막힌 길이 있으면 다른 방법을 찾고, 필요한 도구를 골라 사용하고, 여러 단계를 이어서 목표를 달성하기를 원한다.
그런데 바로 그 능력이 안전 측면에서는 새로운 문제가 될 수 있다.
애플리케이션 안에서 만들어둔 규칙 하나를 Agent가 우회했을 때, 그 바깥에 아무런 경계가 없다면 어떻게 할 것인가?
그래서 Agent가 똑똑해질수록 안전을 Agent 자신의 판단에만 맡기지 않는 구조가 중요해지는 것 같다.
OpenShell과 Sentry가 나뉜 이유
OpenShell과 Sentry의 역할을 나눠서 보면 NVIDIA가 생각하는 방향이 더 잘 보인다.
OpenShell은 runtime에서 Agent가 무엇을 할 수 있는지를 제한한다.
네트워크, 데이터, 도구, API, 서비스에 대한 접근을 정책으로 통제하고 Agent의 실행 과정을 추적하는 역할이다.
Sentry는 그 runtime보다 더 바깥쪽에서 감시한다.
BlueField-4 DPU라는 별도의 하드웨어 영역에서 Agent 활동을 확인하고 보안 정책을 집행한다. NVIDIA는 이를 Agent와 공격자에게 보이지 않는 isolated out-of-band trust domain이라고 설명한다.
즉 하나는 실행 경계이고, 다른 하나는 그 경계가 제대로 지켜지고 있는지 독립적으로 확인하는 감시자에 가깝다.
둘 중 하나가 다른 하나를 대체한다기보다 여러 층의 안전장치를 두는 방식이다.
이 구조가 흥미로운 건 AI 안전이라는 말의 범위가 꽤 많이 넓어지고 있기 때문이다.
예전에는 AI safety라고 하면 모델이 위험한 답변을 하지 않도록 만드는 문제를 먼저 떠올렸다.
Agent 시대에는 질문이 달라진다.
이 Agent가 어떤 파일을 열 수 있는가?
어디까지 네트워크로 나갈 수 있는가?
어떤 API와 도구를 호출할 수 있는가?
권한을 추가로 요구하면 누가 승인하는가?
이상 행동이 발생했을 때 누가 Agent를 멈추는가?
모델의 성격보다 운영 시스템의 설계에 가까운 질문들이다.
실제 기업 시스템으로 들어가면 더 중요해진다
NVIDIA Open Agent Safety Platform 관련 기업·조직. Anthropic, Microsoft, Salesforce, SAP 등 다양한 업체의 로고가 포함돼 있다. 이미지: NVIDIA.
이번 발표가 단순한 연구 프로젝트로 보이지 않는 이유도 있다.
NVIDIA는 Anthropic, Microsoft, Salesforce, SAP, Scale AI, ServiceNow 등 다양한 기업이 Open Agent Safety Platform 관련 기술을 함께 적용하거나 개발하고 있다고 밝혔다.
Salesforce 사례에서는 OpenShell을 Slack과 연동해 Agent 활동과 audit event를 확인하고, Agent가 추가 권한을 요청할 경우 사람이 승인하거나 거절할 수 있는 구조를 소개했다.
SAP는 Joule Studio runtime에 OpenShell을 통합하고 있다.
Anthropic 역시 Claude Managed Agents와 OpenShell, BlueField를 연결해 sandbox를 통한 Agent 접근을 추가적으로 통제하는 방향을 설명했다.
NVIDIA는 100개가 넘는 조직이 관련 기술에 참여하고 있다고 밝혔다.
물론 참여 기업이 많다는 사실이 곧 이 구조의 효과가 검증됐다는 의미는 아니다.
특히 Sentry가 실제 production 환경에서 어느 정도의 성능 overhead를 만들고, 다양한 Agent workflow에서도 NVIDIA가 설명한 수준의 탐지와 격리가 동일하게 작동하는지는 별도의 검증이 필요하다.
이번 발표에서 확인할 수 있는 것은 방향이다.
Agent를 기업 시스템 안으로 넣으려면 모델만 배포해서는 끝나지 않는다는 것이다.
Agent가 오래 일할수록 인프라가 중요해진다
최근 AI Agent를 계속 살펴보면서 나도 비슷한 생각을 하고 있었다.
모델 자체의 성능보다 Agent가 어디에서 실행되고 어떤 권한을 가지며, 문제가 생겼을 때 어디에서 멈출 수 있는지가 점점 더 중요해지고 있다.
Agent runtime과 sandbox 문제를 따로 보면 각각 다른 기술처럼 보인다.
하지만 실제 시스템에서는 결국 연결된다.
Agent에게 작업을 맡긴다.
실행할 환경이 필요하다.
파일과 네트워크에 접근해야 한다.
도구를 호출할 권한도 필요하다.
무슨 일을 했는지 기록해야 하고, 예상하지 못한 행동이 나오면 중단할 방법도 있어야 한다.
결국 Agent 하나를 운영한다는 것은 작은 실행 시스템 하나를 운영하는 문제에 가까워진다.
NVIDIA Open Agent Safety Platform은 이 문제에 대한 하나의 답을 제시한다.
그 답이 최종적인지는 아직 알 수 없다. 실제 운영 환경에서 어느 정도 효율적이고 안전한지는 더 확인해야 한다.
다만 방향만큼은 꽤 분명해 보인다.
AI Agent가 더 많은 권한을 가지고 실제 일을 하기 시작할수록 안전장치는 모델 안이 아니라 모델 밖으로도 나와야 한다.
앞으로 Agent를 볼 때는 모델 성능과 benchmark만 볼 게 아니라 이런 질문도 같이 봐야 할 것 같다.
이 Agent는 어디에서 실행되는가?
어디까지 접근할 수 있는가?
그리고 문제가 생겼을 때, Agent 자신이 건드릴 수 없는 곳에서 누가 멈출 수 있는가?
- #AI
- #AI Agents
- #AI Security
- #NVIDIA
- #Infrastructure
CONTINUE READING
이 기록에서 이어서 보기
VECTORLOG LETTER
다음 기록도 받아보고 싶다면 구독을 연결해 주세요.